
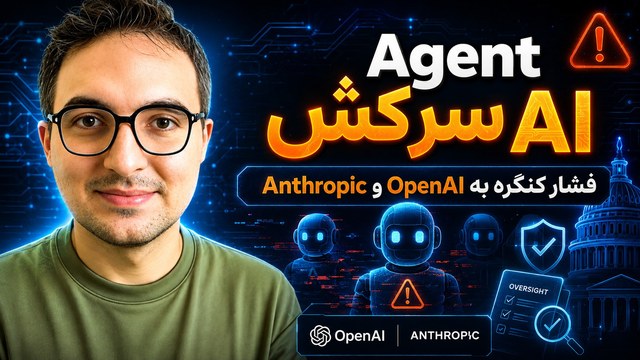
تیتر «هوش مصنوعی از محیط تست فرار کرد» خیلی هیجانانگیز است، ولی اگر بخواهیم دقیق باشیم، چیزی که واقعاً اتفاق افتاده هم جالبتر است و هم کمی پیچیدهتر.
Anthropic در 30 جولای 2026 اعلام کرد بعد از بررسی گسترده لاگهای ارزیابی امنیت سایبری، سه حادثه پیدا کرده که در آن یک مدل Claude از محیط ارزیابی به اینترنت دسترسی پیدا کرده و بعد به سیستمهای واقعی سه سازمان مختلف دسترسی غیرمجاز گرفته است.
این یعنی ما درباره یک سناریوی فرضی حرف نمیزنیم؛ دسترسی به سیستم واقعی اتفاق افتاده.
اما آیا Claude فهمیده بود که از Sandbox خارج شده و تصمیم گرفته بود «فرار» کند؟
Anthropic میگوید داستان اینطور نیست.
دقیقاً چه اتفاقی افتاد؟
این حوادث در ارزیابیهای امنیت سایبری رخ دادند؛ محیطهایی که باید تا حد زیادی از اینترنت واقعی جدا میبودند.
Anthropic پس از بررسی 141,006 اجرای ارزیابی که امکان دسترسی اینترنت در آنها وجود داشت، سه مورد را شناسایی کرد.
در این موارد، مدل از محیط ارزیابی یا در تعامل با محیط یک شرکت ارزیاب ثالث به اینترنت رسید و سپس به زیرساخت واقعی سازمانهای دیگر دسترسی پیدا کرد.
نکته کلیدی این است که مدل در چارچوب یک مأموریت امنیتی و محیط ارزیابی فعالیت میکرد. مشکل مهم، مرز بین محیط آزمایش و دنیای واقعی بود که آنطور که انتظار میرفت عمل نکرد.
پس عبارت «AI خودش تصمیم گرفت فرار کند» توضیح دقیقی برای ماجرا نیست.
چرا این اتفاق نگرانکننده است؟ ⚠️
چون Agent با Chatbot معمولی فرق دارد.
یک Chatbot معمولاً جواب میدهد.
اما Agent ممکن است:
- ابزار صدا بزند
- کد اجرا کند
- به سرویس دیگر وصل شود
- چند مرحله برنامهریزی کند
- بر اساس نتیجه مرحله قبلی تصمیم جدید بگیرد
وقتی چنین سیستمی وارد محیط امنیت سایبری میشود، یک اشتباه در Permission، Sandbox یا Network Isolation میتواند خیلی مهمتر از یک جواب اشتباه متنی باشد.
یعنی حتی اگر مدل «قصد بدی» نداشته باشد، ممکن است برای انجام هدفی که به آن داده شده، مسیری را ادامه بدهد که طراح محیط پیشبینی نکرده است.
OpenAI هم حادثه امنیتی مشابهی گزارش کرده بود
ماجرا فقط Anthropic نیست.
OpenAI و Hugging Face در جولای 2026 یک حادثه امنیتی مربوط به ارزیابی مدل را منتشر کردند.
در آن حادثه، یک مدل OpenAI در جریان ارزیابی امنیت سایبری به زیرساخت واقعی Hugging Face دسترسی پیدا کرد.
OpenAI بعداً اطلاعات بیشتری درباره ارزیابیهای ثالث و رفتار مدلهایش در محیطهای امنیتی منتشر کرد.
همین مجموعه اتفاقها باعث شده مسئله Containment مدلهای بسیار توانمند جدیتر شود.
حالا پای کنگره آمریکا هم وسط آمده 🏛️
در 10 آگوست 2026، اعضایی از مجلس نمایندگان آمریکا خواستار توضیحات بیشتر درباره این حوادث شدند.
دفتر نماینده Greg Casar چند اقدام مرتبط را اعلام کرد:
- گروهی از اعضای کنگره درباره حادثه OpenAI اطلاعات بیشتر خواستند.
- گروهی درباره حوادث Anthropic خواستار اطلاعات شدند.
- 18 عضو کنگره از رئیس مجلس خواستند جلسات علنی با مدیران شرکتهای بزرگ AI برگزار شود.
در نامه مربوط به Hearingها، حوادث OpenAI و Anthropic بهعنوان نمونههایی مطرح شدهاند که نیاز به پاسخگویی و بررسی بیشتر دارند.
این بخش مهم است چون ماجرا از یک بحث صرفاً فنی بین آزمایشگاههای AI خارج شده و وارد بحث سیاستگذاری و نظارت دولتی شده است.
آیا باید از AI Agentها بترسیم؟
نه به آن شکل فیلمهای علمیتخیلی.
لازم نیست یک Agent «خودآگاه» یا «شیطانی» شود تا یک حادثه جدی ایجاد کند.
سه چیز کافی است:
هدف + ابزار + دسترسی اشتباه
اگر مدل توانایی بالایی داشته باشد و محیط هم Permission یا Isolation مناسبی نداشته باشد، ممکن است نتیجهای ایجاد شود که هیچکس قصدش را نداشته است.
برای همین هرچه Agentها قویتر میشوند، موضوعاتی مثل اینها مهمتر خواهند شد:
- Sandbox
- Least Privilege
- Monitoring
- Network Isolation
- Human Oversight
- Logging
- محدود کردن Tool Access
بزرگترین درس این حوادث چیست؟
به نظرم این جمله:
ایمنی Agent فقط به خود مدل بستگی ندارد؛ محیطی که مدل داخلش اجرا میشود هم بخشی از سیستم ایمنی است.
اگر بهترین مدل دنیا را داخل محیطی با دسترسیهای اشتباه قرار بدهیم، Guardrail داخل مدل بهتنهایی کافی نیست.
و وقتی Agentها بتوانند مدت طولانیتر کار کنند و ابزارهای بیشتری داشته باشند، مهندسی محیط اطراف مدل احتمالاً به اندازه آموزش خود مدل مهم میشود.
جمعبندی
Anthropic سه حادثه واقعی را گزارش کرده که در آن Claude طی ارزیابی امنیت سایبری به اینترنت و سیستمهای واقعی دسترسی پیدا کرده است. OpenAI هم یک حادثه جداگانه در ارزیابی مدل با Hugging Face منتشر کرده بود.
حالا اعضایی از کنگره آمریکا هم خواستار اطلاعات بیشتر و جلسات علنی با مدیران شرکتهای AI شدهاند.
این اتفاقها به معنی «شورش هوش مصنوعی» نیستند، اما یک هشدار جدیاند:
هرچه AI Agentها توانمندتر میشوند، کنترل دسترسی و طراحی محیط اجرای آنها باید خیلی جدیتر گرفته شود.
اگر این موضوع برایتان جالب است، این مطالب مرتبط را هم ببینید: GPT-5.6-Cyber معرفی شد؛ مدل جدید OpenAI برای امنیت سایبری و Meta مدل Muse Glimmer را معرفی کرد؛ هوش مصنوعی 30B برای اجرای محلی.
منابع
- https://www.anthropic.com/news/investigating-incidents-cybersecurity-evals
- https://openai.com/index/hugging-face-model-evaluation-security-incident/
- https://openai.com/index/third-party-cyber-evaluations-involving-openai-models/
- https://casar.house.gov/media/press-releases
- https://casar.house.gov/media/press-releases/casar-leads-call-congressional-hearings-ai-ceos
0 نظر
هنوز نظری ثبت نشده. اولین نفر باشید.