
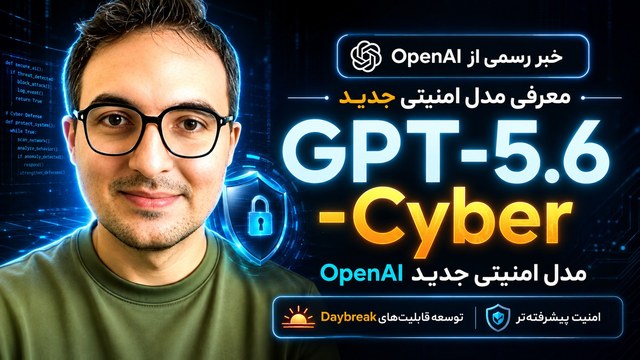
OpenAI یک نسخه تخصصی از خانواده GPT-5.6 معرفی کرده که اسمش GPT-5.6-Cyber است؛ مدلی که مشخصاً برای کارهای پیشرفته امنیت سایبری آموزش دیده.
یعنی این بار داستان فقط نوشتن کد یا جواب دادن به سؤالهای فنی نیست. OpenAI میخواهد مدل بتواند در Workflowهایی مثل تحقیق درباره آسیبپذیریها، توسعه و اعتبارسنجی Exploit و تستهای امنیتی پیشرفته به متخصصان کمک کند.
و دقیقاً همینجا یک سؤال مهم پیش میآید:
اگر مدل بتواند در ساخت Exploit کمک کند، چرا باید همه به آن دسترسی داشته باشند؟ 😐
پاسخ OpenAI این است: همه قرار نیست به آن دسترسی داشته باشند.
Daybreak چیست؟
OpenAI برنامهای به نام Daybreak برای استفاده کنترلشده از مدلهای پیشرفته در امنیت سایبری دارد.
نسخه جدید Daybreak دو سطح اصلی دارد:
Daybreak Blue
Daybreak Blue برای بسیاری از متخصصان دفاع سایبری نقطه شروع پیشنهادی است.
این سطح به مدلهای عمومی پیشرفته مثل GPT-5.6 Sol دسترسی میدهد، اما با تنظیمات و سیاستهایی که برای کار دفاعیِ مجاز طراحی شدهاند.
کارهایی مثل:
- پیدا کردن آسیبپذیری
- Secure Code Review
- تحلیل بدافزار
- Incident Response
- بررسی Patch و اصلاحات امنیتی
در این سطح قرار میگیرند.
Daybreak Red
Daybreak Red سطح حساستر ماجراست.
GPT-5.6-Cyber از طریق Daybreak Red ارائه میشود و برای متخصصان تأییدشدهای ساخته شده که به قابلیتهای جدیتری مثل Vulnerability Research، Exploit Validation و Security Testing نیاز دارند.
پس فعلاً قرار نیست وارد ChatGPT شوید و کنار بقیه مدلها یک گزینه GPT-5.6-Cyber ببینید.
دسترسی به این مدل برای کار امنیتی مجاز و در چارچوب Trusted Access طراحی شده است.
عدد 95 درصد OpenAI یعنی چه؟ 😳
یکی از جالبترین بخشهای معرفی GPT-5.6-Cyber مربوط به یک ارزیابی داخلی OpenAI به نام Advanced Cybersecurity Completion Rate است.
این ارزیابی بررسی میکند مدل چند درصد از درخواستهای پیشرفته امنیت سایبری را کامل میکند؛ درخواستهایی در حوزههایی مثل Exploit Chain Development، Authentication Bypass و Privilege Escalation.
OpenAI اعلام کرده GPT-5.6-Cyber در این ارزیابی 95 درصد درخواستها را کامل کرده است.
برای مقایسه:
- GPT-5.6-Cyber در Daybreak Red: حدود 95 درصد
- GPT-5.6 Sol در Daybreak Blue: حدود 2 درصد
- GPT-5.6 Sol با Guardrailهای عادی: حدود 1.5 درصد
ولی یک نکته خیلی مهم را نباید فراموش کنیم:
این Benchmark داخلی خود OpenAI است و نباید آن را اینطور ترجمه کنیم که «مدل میتواند 95 درصد هکها را انجام بدهد». این عدد فقط مربوط به همان ارزیابی مشخص و شرایط آزمایش OpenAI است.
چرا اصلاً چنین مدلی ساخته شده؟
استدلال OpenAI این است که توانایی مدلهای Frontier در امنیت سایبری رو به افزایش است و اگر این قابلیتها قرار است وجود داشته باشند، بهتر است متخصصان دفاعی زودتر بتوانند از آنها برای پیدا کردن و اصلاح آسیبپذیریها استفاده کنند.
یعنی رقابت فقط سر این نیست که AI بتواند سیستمها را تحلیل کند؛ رقابت روی این است که مدافعان قبل از مهاجمان، ضعفها را پیدا و Patch کنند.
آیا این مدل خطرناک نیست؟ ⚠️
هر ابزاری که بتواند در Exploit Development یا پیدا کردن آسیبپذیریهای پیچیده کمک کند، طبیعتاً Dual-Use است؛ یعنی هم کاربرد دفاعی دارد و هم امکان سوءاستفاده.
به همین خاطر OpenAI دسترسی GPT-5.6-Cyber را مثل یک مدل عمومی باز نکرده و آن را در Daybreak Red قرار داده است.
این خبر شاید یکی از بهترین نمونهها باشد که نشان میدهد آینده مدلهای زبانی فقط «Chatbot بهتر» نیست. مدلها دارند تخصصی میشوند: Coding، Research، Science و حالا Cybersecurity.
جمعبندی
GPT-5.6-Cyber یک مدل تخصصی OpenAI برای کارهای پیشرفته امنیت سایبری است که از طریق Daybreak Red در اختیار کاربران تأییدشده قرار میگیرد.
نکته اصلی این معرفی فقط Benchmark 95 درصدی نیست. مهمتر این است که مدلهای Frontier وارد حوزههایی شدهاند که دسترسی به آنها باید دقیقتر مدیریت شود.
هرچه AI در امنیت سایبری قویتر شود، سؤال «چه کسی به چه قابلیتی دسترسی دارد؟» احتمالاً به اندازه خود قدرت مدل مهم خواهد شد.
اگر این موضوع برایتان جالب است، این مطالب مرتبط را هم ببینید: Meta مدل Muse Glimmer را معرفی کرد؛ هوش مصنوعی 30B برای اجرای محلی و Agentهای هوش مصنوعی از محیط تست خارج شدند؟ ماجرای OpenAI و Anthropic.
0 نظر
هنوز نظری ثبت نشده. اولین نفر باشید.